No desenvolvimento de software, muitas decisões já são resolvidas com regras simples. Se o pedido está atrasado, mostre um aviso. Se o usuário não tem permissão, negue o acesso. Esse tipo de lógica é previsível e deve continuar no código.
Mas e quando a decisão depende de interpretar uma mensagem, entender o contexto ou comparar informações escritas de formas diferentes? É aí que um modelo de linguagem pode ajudar. Em vez de pedir uma resposta aberta em formato de conversa, podemos apresentar o estado atual, explicar o que precisa ser avaliado e definir o formato esperado para a resposta.
Você vai ver por que essa estrutura é importante e como usar modelos de decisão em situações do dia a dia de uma aplicação. O Jev é um exemplo concreto desse tipo de abordagem: recebe um estado e perguntas estruturadas e devolve decisões tipadas com probabilidades. O interesse aqui não depende de um modelo ou fornecedor específico; está em aproximar a interpretação probabilística de uma resposta que o software consegue validar e consumir.
Pontos-chave
- Modelos de decisão transformam uma avaliação em uma resposta estruturada que a aplicação consegue consumir.
- Um modelo de decisão pode especializar um LLM existente; não necessariamente implica uma arquitetura específica.
- Uma decisão do tipo
choiceescolhe entre opções conhecidas,noulavalia uma pergunta de sim ou não escoreatribui uma pontuação em uma escala definida. - Em
choiceescore, a confiabilidade ou grau de concentração da distribuição de probabilidades (confidence) faz parte da resposta por design. - Critérios claros e dados relevantes melhoram a qualidade da avaliação.
- A resposta do modelo é uma entrada para o sistema, não uma regra infalível. Valide-a antes de executar ações importantes.
O que é um modelo de decisão?
Uma decisão em uma aplicação normalmente tem três partes:
- O estado que será avaliado
- A pergunta que precisa ser respondida
- Os critérios que delimitam as respostas possíveis.
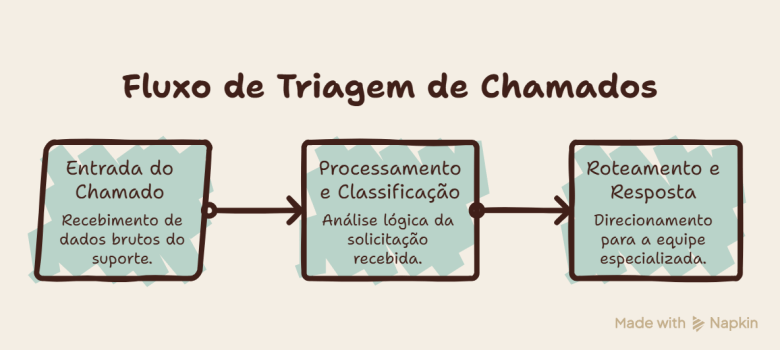
Pense em uma mensagem enviada ao suporte. O estado pode conter a mensagem do cliente e a situação do sistema. A pergunta pode ser “qual equipe deve atender este chamado?”. Os critérios podem ser os nomes das equipes como billing, technical ou other, cada um com uma descrição.
O modelo analisa essas informações e retorna uma das opções. O ponto importante é que a resposta não precisa ser um parágrafo para alguém interpretar depois. Ela pode ser um valor conhecido pela aplicação, acompanhado de probabilidades ou de uma pontuação.
Isso é diferente de pedir algo genérico como “leia esta mensagem e me diga o que fazer”. Uma instrução vaga deixa espaço para respostas inesperadas e torna mais difícil escrever código confiável em volta delas.
Modelos de decisão são uma arquitetura nova?
Não necessariamente. Um modelo de decisão pode partir de um LLM existente, ajustado para comparar alternativas ou estimar resultados, e pode usar diferentes técnicas internas para produzir sua resposta. A interface usada pela aplicação não revela, por si só, como o modelo foi treinado ou implementado. Por isso, afirmações sobre arquitetura devem ser verificadas na documentação e no cartão de cada modelo, e não inferidas apenas pelo rótulo “modelo de decisão”.
O ponto prático é a diferença entre pedir uma explicação em texto e pedir uma avaliação dentro de critérios delimitados. No segundo caso, o contexto e as respostas possíveis são apresentados de forma explícita, e a API devolve uma escolha, probabilidades ou uma pontuação/escala em um formato previsível.
APIs de decisão em diferentes provedores
Há mais de uma forma de disponibilizar esse tipo de capacidade. Um provedor pode oferecer uma API e modelos próprios; um agregador pode encaminhar solicitações para modelos de vários fabricantes usando uma API comum; uma aplicação local pode expor uma API compatível e executar modelos baixados (exemplo – Ollama); ou uma aplicação pode integrar um serviço externo à infraestrutura de nuvem que já utiliza.
Alguns exemplos ajudam a reconhecer essas diferenças. A API de decisões da OpenAI documenta perguntas como predicate, choice e score. A documentação de decisões do OpenRouter descreve o acesso a modelos de decisão por uma interface agregadora, enquanto seu catálogo de modelos permite consultar os modelos listados pelo serviço. A Ollama documenta a API System One, compatível com a API Jev, e distribui modelos como Nimble e Tev1. Já os materiais do AWS Builder sobre Jev e serviços AWS ilustram outra possibilidade: integrar um serviço de decisão externo a uma arquitetura de nuvem.
Esses exemplos não significam que todos os produtos usem a mesma arquitetura, tenham o mesmo conjunto de perguntas ou sejam baseados no Jev. Compatibilidade de API também não garante resultados equivalentes. Antes de escolher uma opção, confira o contrato atual, os modelos disponíveis, as métricas retornadas, os limites operacionais e as condições de execução. Catálogos, nomes, versões e status de disponibilidade mudam; os conceitos deste artigo independem deles.
Esse tipo de API também não é apenas um recurso de Structured Outputs. Restringir a forma de uma resposta ajuda a obter dados válidos, mas uma API de decisão coloca a avaliação de alternativas e, quando disponível, suas probabilidades no centro do contrato.
Por que isso importa para quem desenvolve?
A aplicação recebe dados, não apenas texto
Uma resposta em texto livre pode variar de uma execução para outra. A aplicação teria de interpretar frases, lidar com formatos inesperados e decidir o que fazer quando o modelo responde algo fora do padrão.
Com uma decisão estruturada, o resultado já tem um formato previsto. Uma categoria pode ser comparada com uma lista de opções; uma probabilidade pode ser comparada com um limite; uma pontuação pode ser encaminhada para uma fila de revisão.
As regras ficam mais explícitas
Escrever os critérios ajuda a esclarecer o que cada resultado significa. Se technical inclui indisponibilidade, erros de integração e falhas de software, essa definição fica visível no pedido e pode ser revisada junto com o código.
Isso também ajuda a encontrar lacunas. Se nenhuma opção descreve um caso possível, é melhor descobrir isso antes de depender do resultado em produção.
A confiabilidade das escolhas faz parte da resposta
Um diferencial importante do System One é que, para perguntas choice e score, a resposta inclui tanto as probabilidades das alternativas quanto a confiabilidade ou grau de concentração da distribuição (confidence). O nome do campo pode sugerir uma probabilidade de acerto, mas essa métrica não é um texto que o modelo acrescenta à resposta nem uma estimativa de acerto: é calculada a partir das probabilidades.
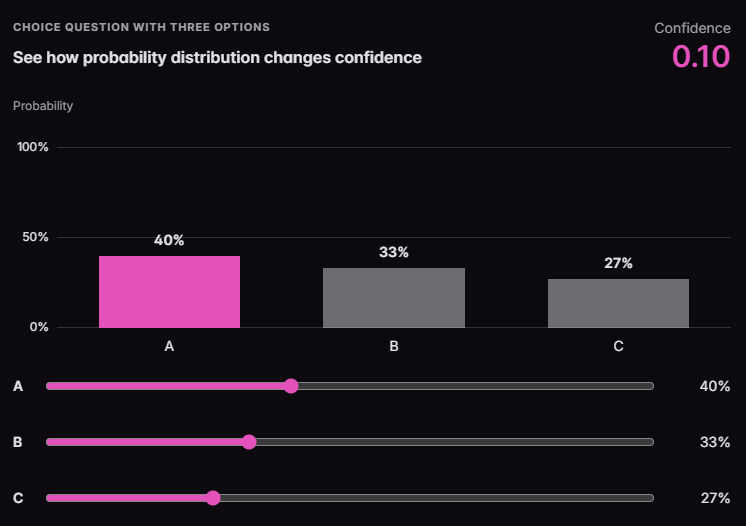
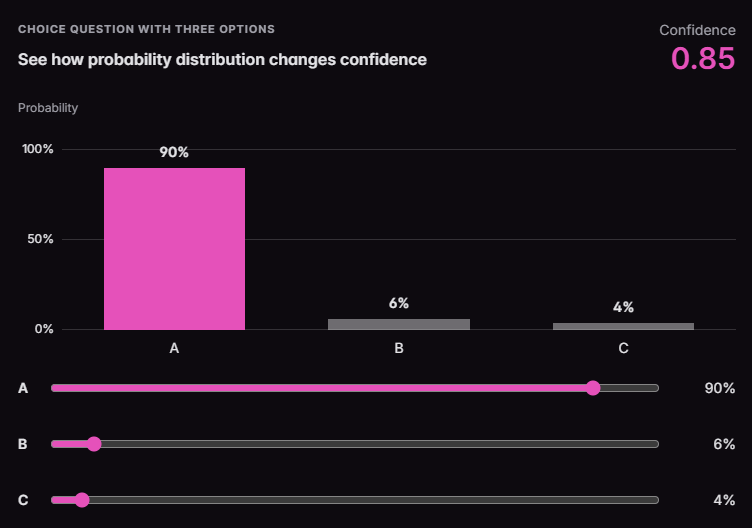
Quando as probabilidades estão distribuídas uniformemente, a concentração é zero. Quando uma alternativa concentra quase toda a probabilidade, a métrica se aproxima de um.
Em muitas integrações genéricas com modelos de linguagem, a aplicação recebe apenas texto livre e precisa inventar uma forma de extrair um rótulo ou obter uma métrica equivalente a confidence. Aqui, as probabilidades e essa métrica fazem parte do formato da resposta desde o início. Isso facilita definir limites e encaminhar distribuições mais dispersas para revisão, mas não significa que um confidence alto garanta que a decisão esteja correta.
Os exemplos abaixo foram tirados da documentação da TypeSafe.
O primeiro mostra como a baixa concentração de probabilidades resulta num confidence baixo. Em outras palavras, não há tanta certeza de que a escolha mais provável está correta.
O segundo mostra o contrário: temos um vencedor claro. A opção A tem 90% de probabilidade de ser a escolha correta, o que joga a confiabilidade da resposta bem para cima. Ainda assim, vale a pena revisar a decisão para fluxos mais críticos.
É possível testar o comportamento
Com entradas e saídas definidas, fica mais fácil montar um conjunto de exemplos e verificar como o sistema se comporta. Como o resultado de um modelo pode variar, esses testes não substituem avaliações periódicas, mas ajudam a identificar mudanças e casos em que os critérios precisam melhorar.
Três formas de formular uma decisão
Na API System One, há três tipos de perguntas úteis para esses cenários.
1. choice: escolher entre opções
Use choice quando você conhece as categorias possíveis e quer que o modelo selecione uma delas. É uma boa opção para classificar chamados, identificar o assunto de uma mensagem ou escolher uma ação dentro de um conjunto permitido.
Por exemplo, descreva cada categoria com o tipo de mensagem que ela inclui:
- Permitir: conversa respeitosa que não exige ação, como uma pergunta sobre a nova versão.
- Spam: propaganda não solicitada ou tentativa de golpe, como uma oferta suspeita.
- Assédio: insultos ou ataques direcionados, como “Você é um idiota. Ninguém quer ouvir você”.
- Outro: mensagem que precisa de atenção, mas não se encaixa nas categorias anteriores.
A resposta inclui a escolha, as probabilidades associadas às opções e o confidence, que representa o grau de concentração dessa distribuição. Esses valores ajudam a avaliar o resultado, mas não devem ser tratados automaticamente como uma garantia de acerto.
2. noul: avaliar uma pergunta de sim ou não
Use noul quando a pergunta pode ser formulada como uma condição binária: “o cliente pediu um reembolso explicitamente?” ou “esta mensagem viola as regras do chat?”.
Para essa pergunta, explique o que caracteriza cada resposta:
- Não: a mensagem é respeitosa, mantém o assunto e não divulga promoções sem solicitação. Uma pergunta educada sobre a nova versão é um exemplo.
- Sim: a mensagem desrespeita uma ou mais dessas regras. Um insulto direto, como “Você é um idiota”, é um exemplo.
A resposta indica a probabilidade de a mensagem violar as regras. Uma probabilidade alta pode levar a mensagem para revisão, mas o limite para isso depende do impacto e deve ser definido pela aplicação.
3. score: avaliar em uma escala
Use score quando a resposta tiver níveis ordenados, como urgência ou gravidade. Em vez de perguntar apenas se um caso é urgente, você pode definir uma escala como “normal”, “alerta” e “urgente”.
Para classificar mensagens, por exemplo, descreva cada nível de gravidade para deixar clara a diferença entre as pontuações:
- 0: mensagem sem violação.
- 1: preocupação leve ou ambígua.
- 2: violação clara, mas de baixo impacto.
- 3: violação séria que merece revisão, como um insulto direto.
- 4: caso grave que exige atenção imediata.
A resposta inclui a pontuação, a distribuição de probabilidades e o confidence, que representa o grau de concentração dessa distribuição.
Uma escala só é útil quando faz sentido que os níveis tenham uma ordem. Para escolher entre categorias sem relação de ordem, prefira choice.
Exemplo prático: classificar um chamado
Neste exemplo, o mesmo chamado recebe três avaliações: equipe responsável, solicitação explícita de reembolso e urgência.
SupportTicket ticket = new( CustomerMessage: "I was charged twice. Please refund the extra payment.", ServiceStatus: "The checkout service is returning HTTP 500 errors.");SystemOneRequest<SupportTicket> request = new( Model: "nimble", State: ticket, Questions: new Dictionary<string, SystemOneQuestion> { ["intent"] = new ChoiceQuestion( Instructions: "Which support team should handle this ticket?", Criteria: new Dictionary<string, string?> { ["billing"] = "Payments, duplicate charges, and refunds", ["technical"] = "Software errors, outages, and integrations", ["other"] = "None of the listed teams applies", }), ["refund_requested"] = new NoulQuestion( Instructions: "Does the customer explicitly request a refund?", Criteria: new NoulCriteria( False: "No refund is requested", True: "The customer requests a refund")), ["urgency"] = new ScoreQuestion( Instructions: "How urgent is this request?", Criteria: [ "Routine: no immediate service impact", "Soon: a customer is inconvenienced", "Immediate: a critical service is unavailable", ]), });SystemOneResponse result = await client.AskAsync(request);if (result.Answers["intent"] is ChoiceAnswer intent){ Console.WriteLine($"Team: {intent.Choice} (concentração / confidence: {intent.Confidence:P1})");}if (result.Answers["refund_requested"] is NoulAnswer refund){ Console.WriteLine($"Refund request probability: {refund.Noul:P1}");}if (result.Answers["urgency"] is ScoreAnswer urgency){ Console.WriteLine($"Urgency: {urgency.Score:F2}");}
O que gera uma saída mais ou menos assim:
Team: billing (confidence: 82.4%)Refund request probability: 98.7%Urgency: 1.42
O código envia um estado e três perguntas nomeadas. Isso é documentado como uma boa prática, pois os modelos podem processar as perguntas em paralelo. Depois, a aplicação acessa cada resposta pelo nome e confere seu tipo antes de usá-la. O exemplo assume que o client já foi configurado apontando para uma API de decisão; consulte o repositório do projeto para ver os exemplos completos.
Esse padrão serve para muitos fluxos. Uma aplicação de moderação pode classificar uma mensagem, estimar a probabilidade de violação de uma regra e avaliar a gravidade. Um sistema de atendimento pode identificar o assunto, verificar se há uma solicitação explícita e estimar a urgência.
O modelo sugere; a aplicação decide o que fazer
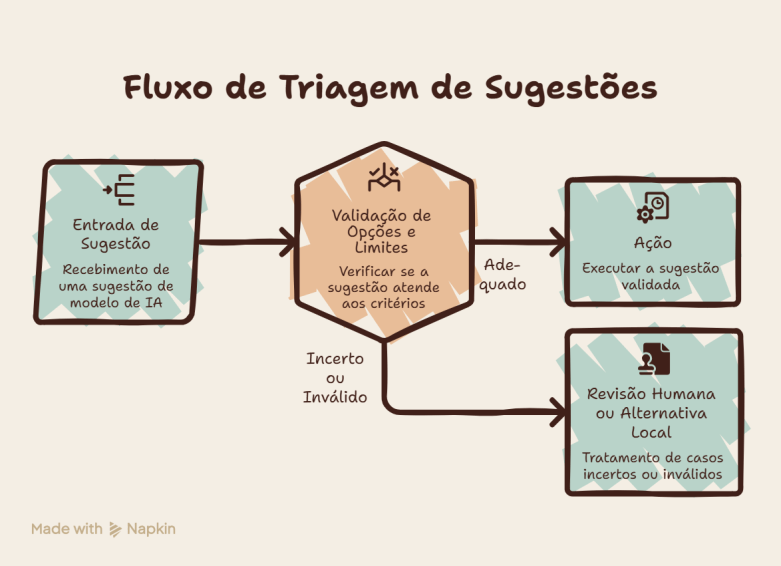
Uma resposta estruturada não elimina a necessidade de validação. Antes de usar a decisão, confira se o resultado está entre as opções permitidas e defina o que acontece quando a distribuição é dispersa ou a resposta não atende às expectativas.
No exemplo de um jogo da velha, por exemplo, a aplicação envia ao modelo somente as casas livres. Mesmo assim, o código valida a jogada recebida e usa uma alternativa local se o modelo retornar algo inválido. A regra que protege o estado do jogo continua sob controle da aplicação.
Esse cuidado é ainda mais importante em ações financeiras, moderação de contas, concessão de acesso e qualquer operação difícil de desfazer. Nesses casos, talvez seja necessário solicitar revisão humana, registrar a decisão ou exigir uma confirmação adicional.
Também não faz sentido usar um modelo para regras determinísticas. Se a resposta depende de comparar uma data ou verificar uma permissão, uma regra implementada no código costuma ser mais simples, barata e previsível. O modelo de IA é mais útil quando existe conteúdo ambíguo ou não estruturado que precisa ser interpretado.
Como começar
- Escolha um caso em que a aplicação já precise interpretar texto ou contexto.
- Defina as respostas possíveis e escreva critérios que diferenciem cada uma.
- Reúna exemplos reais ou representativos, incluindo casos ambíguos e fora do padrão.
- Compare as respostas com o resultado esperado e ajuste as instruções e os critérios.
- Defina limites, validações e caminhos de revisão antes de automatizar ações importantes.
- Acompanhe os resultados em produção e atualize os exemplos quando o comportamento esperado mudar.
Modelos de decisão ajudam a conectar a capacidade de interpretação de um modelo de linguagem com o fluxo de uma aplicação. O ganho não está em entregar qualquer decisão para a IA, mas em formular bem o problema, restringir a resposta e manter no código as validações que protegem o sistema.
Para ver esses exemplos em funcionamento, consulte no meu repositório os projetos de classificação de chamados, moderação de chat e jogo da velha, além da documentação da API System One e do guia de decisões da Ollama. Os detalhes sobre a base e o treinamento estão nos cartões de modelo do Nimble e do Tev1.


